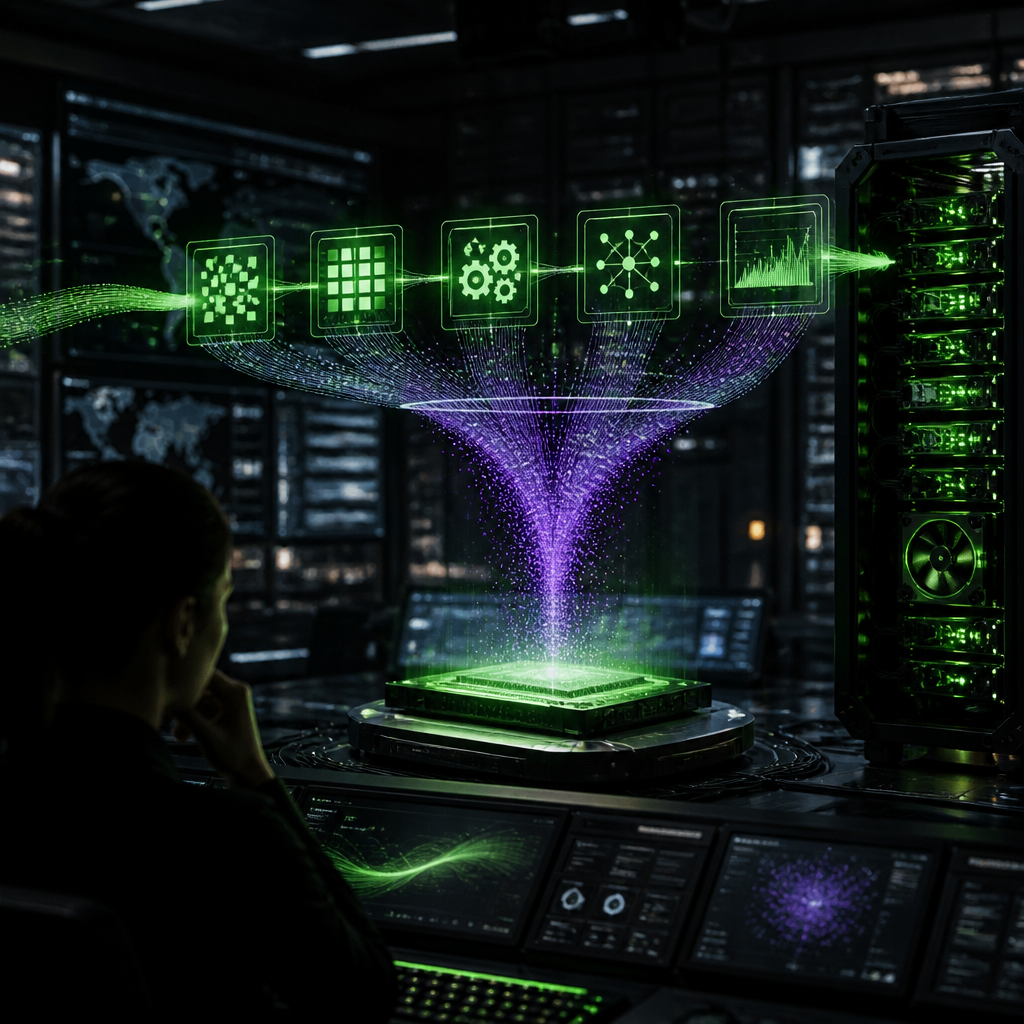
La implementación de flujos de trabajo de Machine Learning (ML) en plataformas NVIDIA está madurando. Los desarrolladores pueden ahora acelerar procesos completos, desde el preprocesamiento hasta la inferencia, utilizando herramientas como cuML y RAPIDS.
Qué está pasando
El ecosistema de IA está consolidando herramientas potentes para la computación en GPU. Recientes demostraciones prácticas detallan cómo construir y acelerar flujos de trabajo de ML completos mediante NVIDIA cuML y RAPIDS. Este enfoque permite a los usuarios ejecutar tareas que tradicionalmente requerían CPU, aprovechando el poder paralelo de las GPUs. Las funcionalidades cubiertas son amplias, incluyendo la aceleración de scikit-learn con `cuml.accel`, el análisis de rendimiento (benchmarking), el agrupamiento (clustering) con UMAP y HDBSCAN, y la explicabilidad de modelos mediante SHAP acelerado por GPU.
Por qué importa
La migración de flujos de trabajo de ML a la GPU aborda directamente los cuellos de botella de rendimiento en el entrenamiento y la inferencia. Al utilizar RAPIDS y cuML, los equipos técnicos pueden reducir drásticamente los tiempos de ejecución, haciendo posible el procesamiento de conjuntos de datos masivos en tiempo real. Esto no solo mejora la eficiencia operativa, sino que también permite el desarrollo de modelos más complejos y la implementación de funcionalidades avanzadas como el aprendizaje de variedades (manifold learning) en entornos de producción más exigentes.
Qué cambia en la práctica
Los profesionales de datos ahora pueden integrar componentes avanzados en un único flujo acelerado. Por ejemplo, es posible realizar la inferencia de modelos basados en árboles con librerías como FIL, y evaluar su rendimiento junto con la explicabilidad (XAI) de manera coherente. La capacidad de realizar benchmarking de rendimiento en algoritmos clave directamente en GPU permite a los arquitectos de sistemas optimizar la infraestructura de IA con una precisión sin precedentes, pasando de la prueba de concepto a la escalabilidad industrial.
Qué vigilar
La tendencia apunta a la integración continua de más módulos de ML en el stack de GPU. Se espera que la convergencia entre la optimización de memoria, la explicabilidad y el rendimiento de la inferencia continúe siendo un foco clave. Los proveedores de hardware y software seguirán emitiendo ejemplos de casos de uso que demuestren la eficiencia de estos flujos, consolidando la GPU como el estándar operativo para la IA de misión crítica.
Más sobre este tema: Herramientas de IA
Fuente de esta noticia: consultar el anuncio o artículo original.
